רגרסיה ליניארית מאפשרת לבחון כיצד משתנה אחד או כמה משתנים קשורים למשתנה תלוי כמותי. ב-SPSS מבצעים אותה דרך Analyze > Regression > Linear. לפני שמפרשים את התוצאות, בודקים את התאמת המודל לנתונים, את דפוס השאריות ואת קיומן של תצפיות משפיעות. לאחר מכן קוראים את טבלאות Model Summary, ANOVA ו-Coefficients, ומדווחים על התאמת המודל, המקדמים ורווחי הסמך.
הפעלת רגרסיה ליניארית ב-SPSS דורשת כמה לחיצות, אבל הפקת פלט אינה מבטיחה שהניתוח מתאים למחקר. כדי להגיע למסקנה מבוססת צריך לבחור משתנים נכון, להבין מה המודל מניח ולדעת להבחין בין קשר מובהק, קשר בעל משמעות מעשית ויכולת ניבוי.
המדריך הבא מציג את התהליך מתחילת העבודה ועד לדיווח התוצאות. הוא מתאים לרגרסיה פשוטה עם מנבא אחד ולרגרסיה מרובה עם כמה מנבאים, במסגרת עבודת סמינריון או מחקר כמותי אחר.
מהי רגרסיה ליניארית ומתי משתמשים בה?
רגרסיה ליניארית מתארת את הקשר בין הממוצע הצפוי של משתנה תלוי כמותי לבין משתנה מסביר אחד או יותר. למשל, אפשר לבדוק כיצד שעות לימוד ומספר היעדרויות קשורים לציון במבחן.
- רגרסיה ליניארית פשוטה: כוללת מנבא אחד, למשל שעות לימוד.
- רגרסיה ליניארית מרובה: כוללת כמה מנבאים, למשל שעות לימוד, היעדרויות וידע קודם.
- המשתנה התלוי: התוצאה שרוצים להסביר או לנבא.
- המשתנים המנבאים: המשתנים שמשמשים להסבר השונות בתוצאה.
ברגרסיה מרובה, כל מקדם מתאר את הקשר בין מנבא מסוים לתוצאה כאשר יתר המנבאים במודל מוחזקים קבועים. זהו קשר מותנה במשתנים שנכללו בניתוח, והוא אינו מוכיח סיבתיות.
מתי רגרסיה ליניארית אינה הבחירה המתאימה?
כאשר המשתנה התלוי בינארי, כמו התקבל או לא התקבל, בדרך כלל בוחרים ברגרסיה לוגיסטית. כאשר התוצאה היא ספירה, כמו מספר ביקורים במרפאה, ייתכן שיתאים מודל לספירות. גם נתונים הכוללים מדידות חוזרות או משתתפים המקובצים בכיתות עשויים לדרוש מודל שמביא בחשבון את התלות ביניהם.
הבחירה צריכה להתחיל בשאלת מחקר ברורה ובסוג הנתונים, ולא בזמינות של כפתור בתוכנה.
שלב 1: הכנת הנתונים לפני הניתוח
במבנה הנתונים הרגיל, כל שורה מייצגת משתתף וכל עמודה מייצגת משתנה. לפני הרצת המודל, בצעו את הבדיקות הבאות:
- בדקו טווחים: ודאו שאין ציונים מחוץ לטווח האפשרי או ערכים שנוצרו מטעות הקלדה.
- הגדירו ערכים חסרים: קוד כמו 999 אינו צריך להיחשב לציון אמיתי.
- בדקו ציוני שאלון: ודאו שפריטים הפוכים קודדו נכון ושהציון הכולל חושב לפי כללי הכלי.
- בדקו הגדרות פעילות: Filter, Split File ו-Weight Cases עלולים לשנות את המדגם ואת החישוב.
- בדקו את מספר המקרים התקפים: המדגם שנותר לניתוח עשוי להיות קטן מהמדגם המקורי.
בניתוח הרגיל עם Exclude cases listwise, משתתף שחסר לו ערך באחד ממשתני המודל אינו נכלל באמידה. אין להחליף חסרים באפס או בממוצע באופן אוטומטי. יש להבין את היקף החסרים, את הסיבות האפשריות להם ואת ההשלכות של שיטת הטיפול שנבחרה.
איך מכניסים משתנה קטגוריאלי לרגרסיה?
משתנה בינארי יכול להיכנס למודל בקידוד 0 ו-1. במקרה כזה, המקדם מבטא את ההפרש הצפוי בין הקבוצה שקודדה 1 לקבוצת הייחוס שקודדה 0, בהינתן יתר המשתנים.
משתנה בעל שלוש קטגוריות ומעלה דורש בדרך כלל יצירת משתני דמה. לדוגמה, עבור שלושה מסלולי לימוד יוצרים שני משתני דמה ומשאירים מסלול אחד כקבוצת ייחוס. הכנסת הקודים 1, 2 ו-3 כמנבא כמותי מניחה מרווחים שווים וקשר ליניארי בין הקטגוריות, ולכן אינה מתאימה אוטומטית.
שלב 2: ביצוע רגרסיה ליניארית ב-SPSS
ההוראות מתייחסות לתיבת הדו-שיח הרגילה של Linear Regression. שמות האפשרויות ומיקומן עשויים להשתנות מעט בין גרסאות ושפות הממשק.
- פתחו את קובץ הנתונים.
- בחרו Analyze > Regression > Linear.
- העבירו את המשתנה התלוי לשדה Dependent.
- העבירו את המנבאים לשדה Independent(s).
- בחרו Method: Enter להכנסת כל המנבאים בבלוק יחד.
- הגדירו את אפשרויות הפלט ובדיקות ההנחות כמפורט בהמשך.
- לחצו Paste לשמירת פקודת הניתוח, או OK להפעלה ישירה.
בחירת המנבאים צריכה להתבסס על תיאוריה, על סקירה ספרותית ועל מטרת המחקר. שיטות אוטומטיות כמו Stepwise עלולות להפיק מודל התלוי מאוד במדגם, ולכן אינן תחליף להצדקה מחקרית.
מה לבחור בחלון Statistics?
- Estimates: להצגת מקדמים ומבחניהם.
- Model fit: להצגת מדדי התאמה ומבחן המודל.
- Confidence intervals: להצגת רווחי סמך למקדמים, בדרך כלל ברמת 95%.
- Collinearity diagnostics: לבדיקת חפיפה בין המנבאים ברגרסיה מרובה.
- R squared change: כאשר משווים בלוקים ברגרסיה היררכית.
מה לבחור בחלון Plots?
הגדירו את *ZPRED בציר X ואת *ZRESID בציר Y. תרשים השאריות מול הערכים החזויים מסייע לזהות עקמומיות ושינוי בפיזור. סמנו גם Histogram ו-Normal probability plot לבחינת התפלגות השאריות.
מה לבחור בחלון Save?
אפשר לשמור שאריות, ערכים חזויים ו-Cook’s distance להמשך בדיקה. לצורך בחינת תצפיות חריגות אפשר לשמור גם Studentized deleted residuals. המשתנים שנשמרים מתווספים לקובץ הנתונים.
שלב 3: בדיקת הנחות הרגרסיה
מהי שארית? שארית היא ההפרש בין הערך שנצפה בפועל לבין הערך שהמודל חזה. למשל, אם הציון בפועל הוא 85 והציון החזוי הוא 80, השארית היא 5. באמצעות השאריות בוחנים עד כמה דפוס הנתונים מתאים למודל.
| מה בודקים? | איך בודקים? | מה מצריך תשומת לב? |
|---|---|---|
| התאמה לצורה הליניארית | תרשימי קשר ושאריות מול ערכים חזויים או מנבאים | דפוס מעוקל או מגמה שיטתית |
| שונות שגיאות קבועה | פיזור השאריות לאורך הערכים החזויים | צורת משפך או פיזור שמתרחב |
| נורמליות השגיאות | היסטוגרמה ותרשים הסתברות של השאריות | אסימטריה חזקה או סטיות בולטות מהקו |
| עצמאות השגיאות | בחינת מבנה המחקר וסדר התצפיות | מדידות חוזרות, אשכולות או תלות לאורך זמן |
| חפיפה בין מנבאים | VIF ו-Tolerance | חפיפה גבוהה שמקשה לאמוד מקדמים יציבים |
| תצפיות משפיעות | שאריות, מינוף ו-Cook’s distance | מקרים ששינוים משנה במידה ניכרת את המודל |
ליניאריות ושונות קבועה
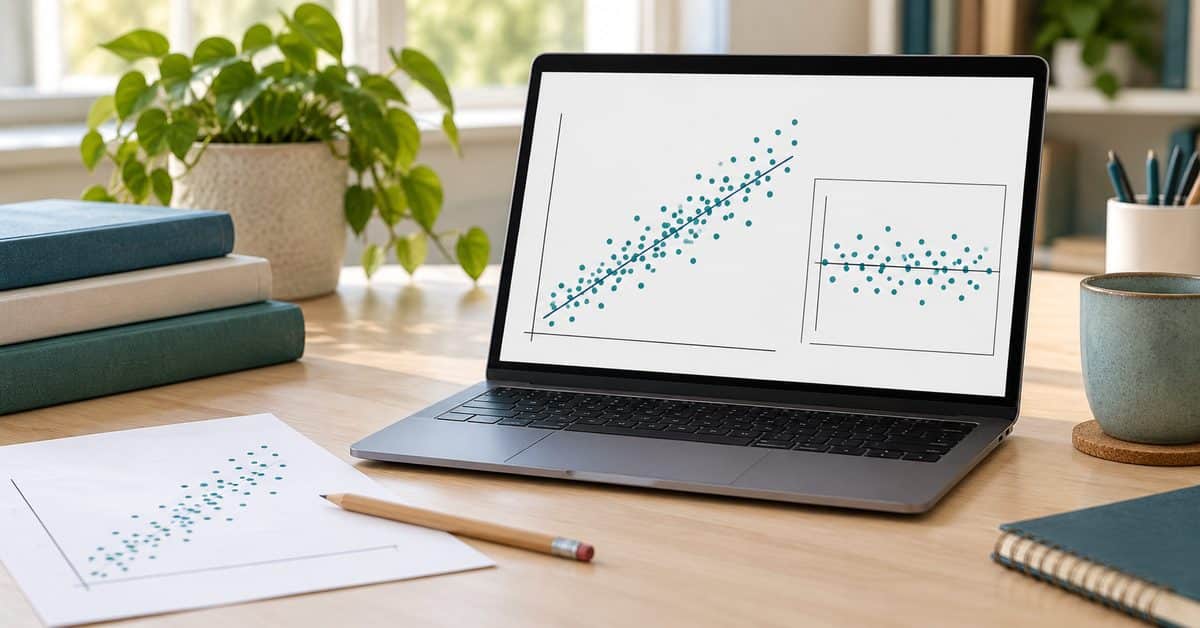
ענן שאריות ללא דפוס ברור, שסביבתו פיזור דומה לאורך הציר, תומך בהתאמת המודל. עקמומיות עשויה להצביע על צורך ברכיב לא ליניארי; צורת משפך עשויה להצביע על שונות שאינה קבועה. תרשים יחיד אינו מספיק לכל בדיקה, ובמודל מרובה כדאי לבחון גם דפוסים ביחס למנבאים השונים.
נורמליות: מה צריך להתפלג נורמלית?
ההנחה נוגעת לשגיאות המודל, שאת התנהגותן מעריכים באמצעות השאריות. אין דרישה שכל מנבא יתפלג נורמלית. נורמליות חשובה במיוחד להסקה הקלאסית במדגמים קטנים, ואין להכריע על התאמת הניתוח רק לפי מבחן נורמליות אחד.
עצמאות: בדיקה שמתחילה בתכנון המחקר
אם אותו משתתף נמדד כמה פעמים, או אם תלמידים שייכים לאותן כיתות, ייתכן שקיימת תלות שהרגרסיה הרגילה אינה מביאה בחשבון. נתון Durbin-Watson רלוונטי בעיקר לבחינת מתאם סדרתי בתצפיות מסודרות; הוא אינו אישור כללי לעצמאות של כל סוגי הנתונים.
מולטיקוליניאריות: איך מפרשים VIF?
VIF מתאר עד כמה החפיפה בין מנבא לבין שאר המנבאים מגדילה את שונות אומדן המקדם שלו. ערך 1 מצביע על היעדר חפיפה ליניארית עם יתר המנבאים. ערכים גבוהים מחייבים בחינה, אך אין סף יחיד שמתאים לכל מחקר. Tolerance הוא ההופכי של VIF, ולכן ערך נמוך שלו משקף חפיפה גבוהה.
אין להסיר משתנה רק כדי לשפר מדד. בדקו אם הוכנסו למודל מדדים כמעט זהים, ציון כולל יחד עם רכיביו, או משתני דמה שקודדו באופן שגוי.
חריגים ותצפיות משפיעות
תצפית חריגה בתוצאה אינה בהכרח תצפית שמשנה מאוד את המקדמים. לכן בוחנים גם מדדי השפעה, ובהם Cook’s distance. ערך בולט ביחס לשאר המקרים מצדיק בירור, ולא מחיקה אוטומטית.
ראשית בדקו אם מדובר בטעות נתונים. אם התצפית תקינה, אפשר לבצע ניתוח רגישות ולהשוות את המסקנות עם התצפית ובלעדיה. יש לתעד את ההחלטה ואת השפעתה על התוצאות.
מה עושים כאשר ההנחות אינן מתאימות?
- קשר שאינו ליניארי: בחנו שינוי בצורת המודל בהתאם לתיאוריה, למשל רכיב ריבועי או טרנספורמציה.
- שונות שאינה קבועה: בחנו שגיאות תקן עמידות או מודל מתאים אחר, בהתאם לאפשרויות התוכנה ולמבנה הנתונים.
- תלות בין תצפיות: שקלו מודל למדידות חוזרות או מודל רב-רמתי.
- תצפיות משפיעות: בדקו מקור, תקינות ורגישות של המסקנות.
- חפיפה גבוהה בין מנבאים: בחנו מחדש את הרכב המודל ואת ההבחנה התיאורטית בין המשתנים.
Bootstrap אינו פתרון אוטומטי לכל הפרה. גם בו צריך להתאים את שיטת הדגימה למבנה הנתונים. לאחר כל שינוי במודל חוזרים לבדיקות הרלוונטיות ומתעדים מה נעשה.
שלב 4: פירוש פלט הרגרסיה ב-SPSS
Model Summary: כמה שונות המודל מסביר?
- R Square: שיעור השונות במשתנה התלוי שמוסבר באמצעות המודל במדגם.
- Adjusted R Square: מדד מתוקן המתחשב במספר המנבאים ובגודל המדגם.
- Std. Error of the Estimate: אומדן פיזור השאריות ביחידות המשתנה התלוי.
אם R² = 0.40, המודל מסביר 40% מהשונות שנצפתה בתוצאה. אין פירוש הדבר שהוא מנבא נכון 40% מהמשתתפים. R² גבוה גם אינו מוכיח סיבתיות או מבטיח ביצועים טובים במדגם חדש. כאשר המטרה היא ניבוי, יש לבחון ביצועים מחוץ לנתונים ששימשו לאמידה.
ANOVA: האם המודל הכולל מובהק?
במודל הרגיל הכולל קבוע, מבחן F בוחן את השערת האפס שלפיה כל מקדמי המנבאים באוכלוסייה שווים לאפס. מובהקות המודל מצביעה על עדות שלפחות אחד מהם שונה מאפס, אך אינה מלמדת שכל מנבא מובהק בפני עצמו.
Coefficients: מה המשמעות של כל מנבא?
| עמודה בפלט | משמעות |
|---|---|
| B | השינוי הצפוי בתוצאה עבור עלייה של יחידה אחת במנבא, בהינתן יתר המנבאים |
| Std. Error | שגיאת התקן של אומדן B |
| Beta | מקדם מתוקנן, המבוטא ביחידות של סטיות תקן |
| t | סטטיסטי לבדיקת המקדם מול אפס |
| Sig. | ערך p של מבחן המקדם |
| 95% Confidence Interval for B | רווח סמך למקדם הלא מתוקנן |
לכתיבת משוואת הניבוי משתמשים ב-B ובקבוע, ולא ב-Beta. המקדם המתוקנן יכול לסייע בהשוואת קשרים בתוך המודל, אך אינו מדד חד-משמעי לחשיבות המנבא. חפיפה בין מנבאים, שונות המדדים ומהימנותם משפיעות על ההשוואה.
אם SPSS מציג Sig. = .000, מדווחים p < .001, ולא p = 0. מובהקות אינה מעידה לבדה על חשיבות מעשית; יש לבחון גם את גודל המקדם, יחידות המדידה ורווח הסמך.
דוגמה לפירוש רגרסיה ליניארית מרובה
הדוגמה הבאה מומצאת לצורכי המחשה ואינה פלט ממחקר אמיתי. נניח שנבדק הקשר בין שעות לימוד שבועיות והיעדרויות לבין ציון במבחן בקרב 100 סטודנטים.
המודל הניב R² = .40, ו-Adjusted R² = .388. מבחן המודל היה מובהק: F(2, 97) = 32.33, p < .001.
| משתנה | B | שגיאת תקן | t | p | רווח סמך 95% |
|---|---|---|---|---|---|
| קבוע | 60.00 | 3.00 | 20.00 | < .001 | 54.05 עד 65.95 |
| שעות לימוד שבועיות | 2.00 | 0.40 | 5.00 | < .001 | 1.21 עד 2.79 |
| מספר היעדרויות | -1.50 | 0.50 | -3.00 | .003 | -2.49 עד -0.51 |
משוואת הניבוי היא:
Predicted score = 60 + 2 × Study hours – 1.5 × Absences
- כל שעת לימוד שבועית נוספת קשורה לעלייה צפויה של שתי נקודות בציון, כאשר מספר ההיעדרויות מוחזק קבוע.
- כל היעדרות נוספת קשורה לירידה צפויה של נקודה וחצי, כאשר שעות הלימוד מוחזקות קבועות.
- המודל מסביר 40% מהשונות בציונים במדגם.
לסטודנט שלומד 10 שעות בשבוע ונעדר פעמיים, הציון החזוי הוא 77. זו תחזית נקודתית; ציון של משתתף יחיד עשוי להיות שונה ממנה. רווח ניבוי למשתתף יחיד מבטא אי-ודאות רחבה יותר מרווח סמך לממוצע הצפוי של משתתפים בעלי אותם ערכי מנבאים.
הקבוע 60 הוא הציון החזוי כאשר שני המנבאים שווים לאפס. המשמעות המעשית שלו תלויה בשאלה אם ערכי אפס רלוונטיים ונמצאים בטווח הנתונים. אין להסיק מהדוגמה שהוספת שעת לימוד תגרום בהכרח לעלייה של שתי נקודות.
איך מדווחים רגרסיה בעבודה אקדמית?
בפרק שיטת מחקר מתארים את המשתנים, הקידוד, שיטת הכנסת המנבאים, הטיפול בחסרים ובדיקות ההתאמה. בפרק התוצאות מציגים את המודל ואת המקדמים. בפרק הדיון מפרשים את משמעות הממצאים ואת מגבלותיהם.
נוסח דיווח לדוגמה
נערכה רגרסיה ליניארית מרובה לבחינת הקשר בין שעות לימוד שבועיות ומספר היעדרויות לבין ציון במבחן. שני המנבאים הוכנסו יחד בשיטת Enter. הניתוח כלל 100 משתתפים. המודל היה מובהק, F(2, 97) = 32.33, p < .001, והסביר 40% מהשונות בציונים, R² = .40, Adjusted R² = .388. שעות לימוד נמצאו קשורות באופן חיובי לציון, B = 2.00, SE = 0.40, 95% CI [1.21, 2.79], p < .001. מספר ההיעדרויות נמצא קשור באופן שלילי לציון, B = -1.50, SE = 0.50, 95% CI [-2.49, -0.51], p = .003.
בדיווח אמיתי יש להוסיף את תוצאות בדיקות ההנחות וכל טיפול שנעשה בעקבותיהן. אין לכתוב שההנחות התקיימו בלי לבדוק אותן. להצגת הממצאים בהקשר המחקרי, אפשר להיעזר במדריך לכתיבת פרק דיון.
רגרסיה היררכית: איך בודקים תרומה של בלוק נוסף?
ברגרסיה היררכית מכניסים קבוצות מנבאים בסדר שנקבע מראש. למשל, בבלוק הראשון מכניסים ידע קודם, ובבלוק השני מוסיפים שעות לימוד והיעדרויות. ב-SPSS משתמשים ב-Next ליצירת בלוק נוסף ומבקשים R squared change.
השינוי ב-R² מתאר כמה שונות מוסברת נוספה בעקבות הבלוק. מבחן F Change בוחן את התרומה הנוספת שלו. יש להצדיק את סדר ההכנסה ולהשוות מודלים המבוססים על אותם משתתפים, כדי שההבדל לא ישקף גם שינוי במדגם.
טעויות נפוצות בפירוש רגרסיה ליניארית
- הסקת סיבתיות מקשר: הכנסת משתני בקרה אינה מבטיחה שכל הגורמים המתערבים נמדדו.
- בלבול בין B ל-Beta: משוואת הניבוי מבוססת על המקדמים הלא מתוקננים.
- פירוש R² כאחוז דיוק: מדובר בשונות מוסברת במדגם.
- התמקדות ב-p בלבד: יש לבחון גם גודל קשר ואי-ודאות.
- מחיקת חריגים כדי להגיע למובהקות: כל החלטה דורשת הצדקה ותיעוד.
- ניבוי מחוץ לטווח הנתונים: אקסטרפולציה עלולה להוביל לתחזיות בלתי מבוססות.
- הצגת פלט ללא הסבר: הקורא צריך להבין מה נבדק ומה נמצא.
שאלות נפוצות על רגרסיה ליניארית ב-SPSS
מה ההבדל בין מתאם לרגרסיה?
מתאם מתאר קשר בין שני משתנים ללא הגדרת אחד מהם כתוצאה. רגרסיה מגדירה משתנה תלוי ומאפשרת לאמוד את הקשר שלו עם מנבא אחד או כמה מנבאים. ברגרסיה מרובה ניתן לבחון קשר עם מנבא מסוים בהינתן האחרים.
האם כל המשתנים חייבים להתפלג נורמלית?
לא. הנחת הנורמליות בהסקה הקלאסית מתייחסת לשגיאות המודל, שנבחנות באמצעות השאריות, ולא להתפלגות של כל משתנה בנפרד.
האם מודל מובהק יכול לכלול מנבאים שאינם מובהקים?
כן. מבחן המודל הכולל ומבחני המקדמים בוחנים השערות שונות. חפיפה בין מנבאים יכולה להקשות על זיהוי תרומתו הנפרדת של כל אחד מהם.
כמה משתתפים צריך לרגרסיה?
אין מספר קבוע שמתאים לכל מודל. גודל המדגם תלוי במספר הפרמטרים, בגודל הקשרים שמבקשים לזהות, בעוצמה הרצויה ובמבנה הנתונים. רצוי לתכנן אותו מראש באמצעות חישוב עוצמה מתאים, ולא להסתפק בכלל אצבע של משתתפים לכל מנבא.
האם R² נמוך אומר שהמודל חסר ערך?
לא בהכרח. המשמעות תלויה בתחום ובמטרת הניתוח. עם זאת, מודל שמסביר מעט שונות עשוי להיות מוגבל לניבוי של תוצאות אישיות, גם אם חלק מהמקדמים מובהקים.
האם צריך להעתיק את כל הפלט לעבודה?
בדרך כלל מציגים טבלה מסודרת ואת הנתונים הרלוונטיים, בהתאם להנחיות המוסד. אפשר לעיין בעבודה סמינריונית לדוגמא כדי להכיר מבנה דיווח, אך יש להתאים אותו למחקר שבוצע בפועל.
רשימת בדיקה לפני הגשת הניתוח
- המשתנה התלוי ומבנה הנתונים מתאימים למודל.
- בחירת המנבאים וסדר הכנסתם מוצדקים.
- הקידוד והטיפול בחסרים מתועדים.
- בדיקות השאריות והתצפיות המשפיעות בוצעו.
- דווחו גודל המדגם, R², מבחן המודל והמקדמים הרלוונטיים.
- המסקנות מבחינות בין קשר, ניבוי וסיבתיות.
- קובץ הנתונים ופקודת הניתוח נשמרו לשחזור.
רגרסיה טובה מחברת בין שאלת המחקר, הנתונים והפרשנות. אם אינכם בטוחים בבחירת המודל או בקריאת התוצאות, ניתן להיעזר בהכוונה בתחום ניתוח סטטיסטי כדי להבין את הפלט ולדווח עליו באופן מבוסס.